2026
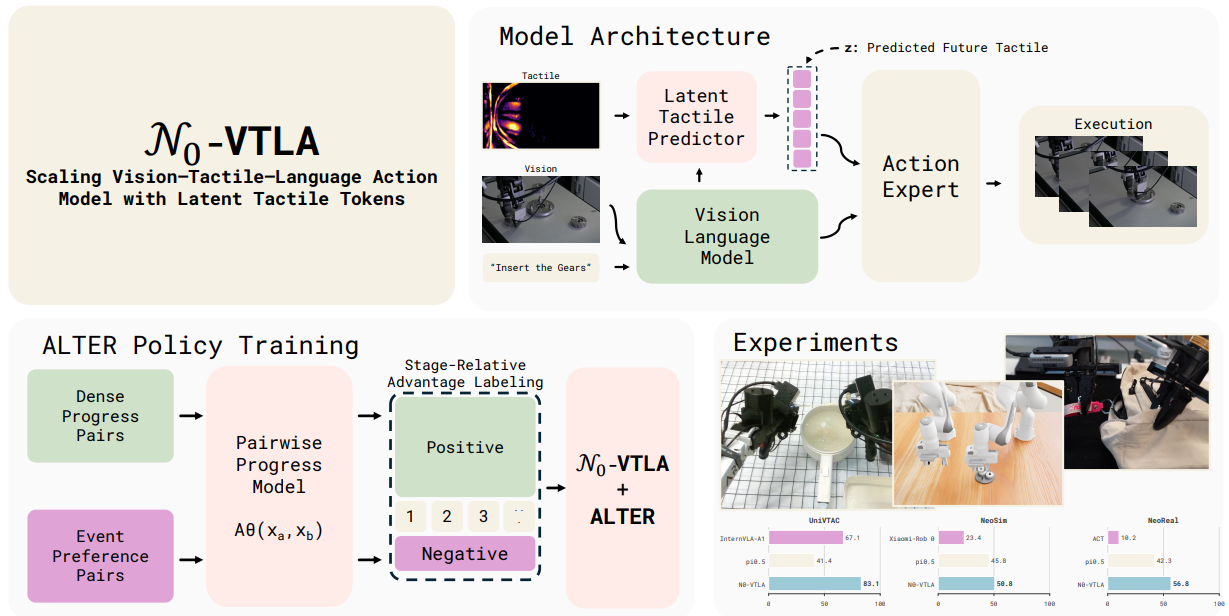
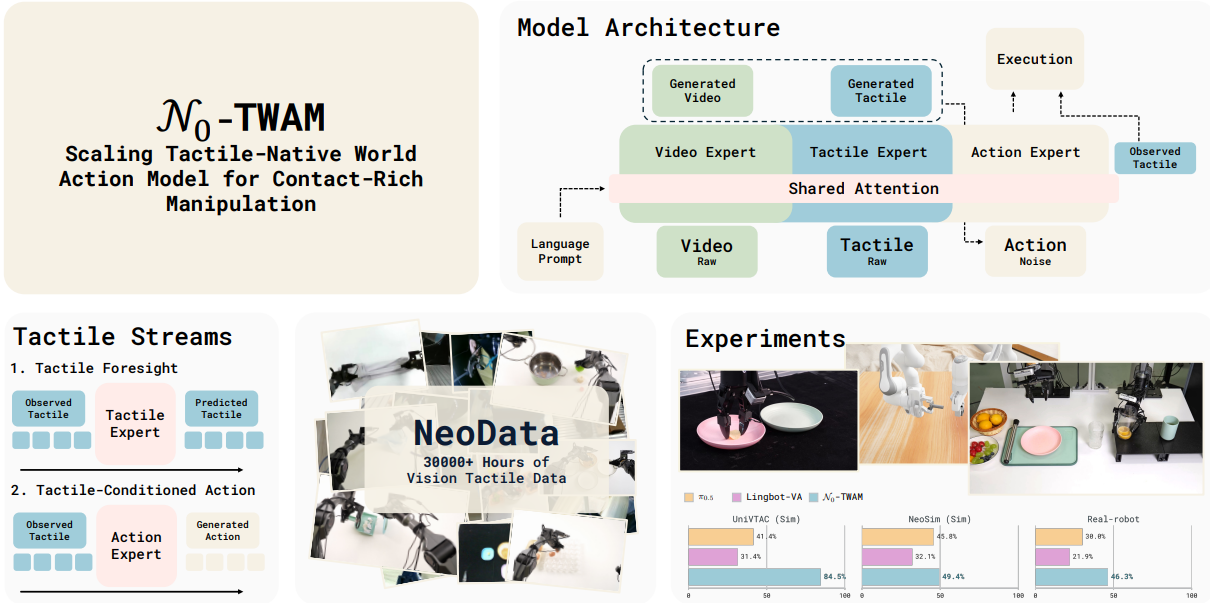
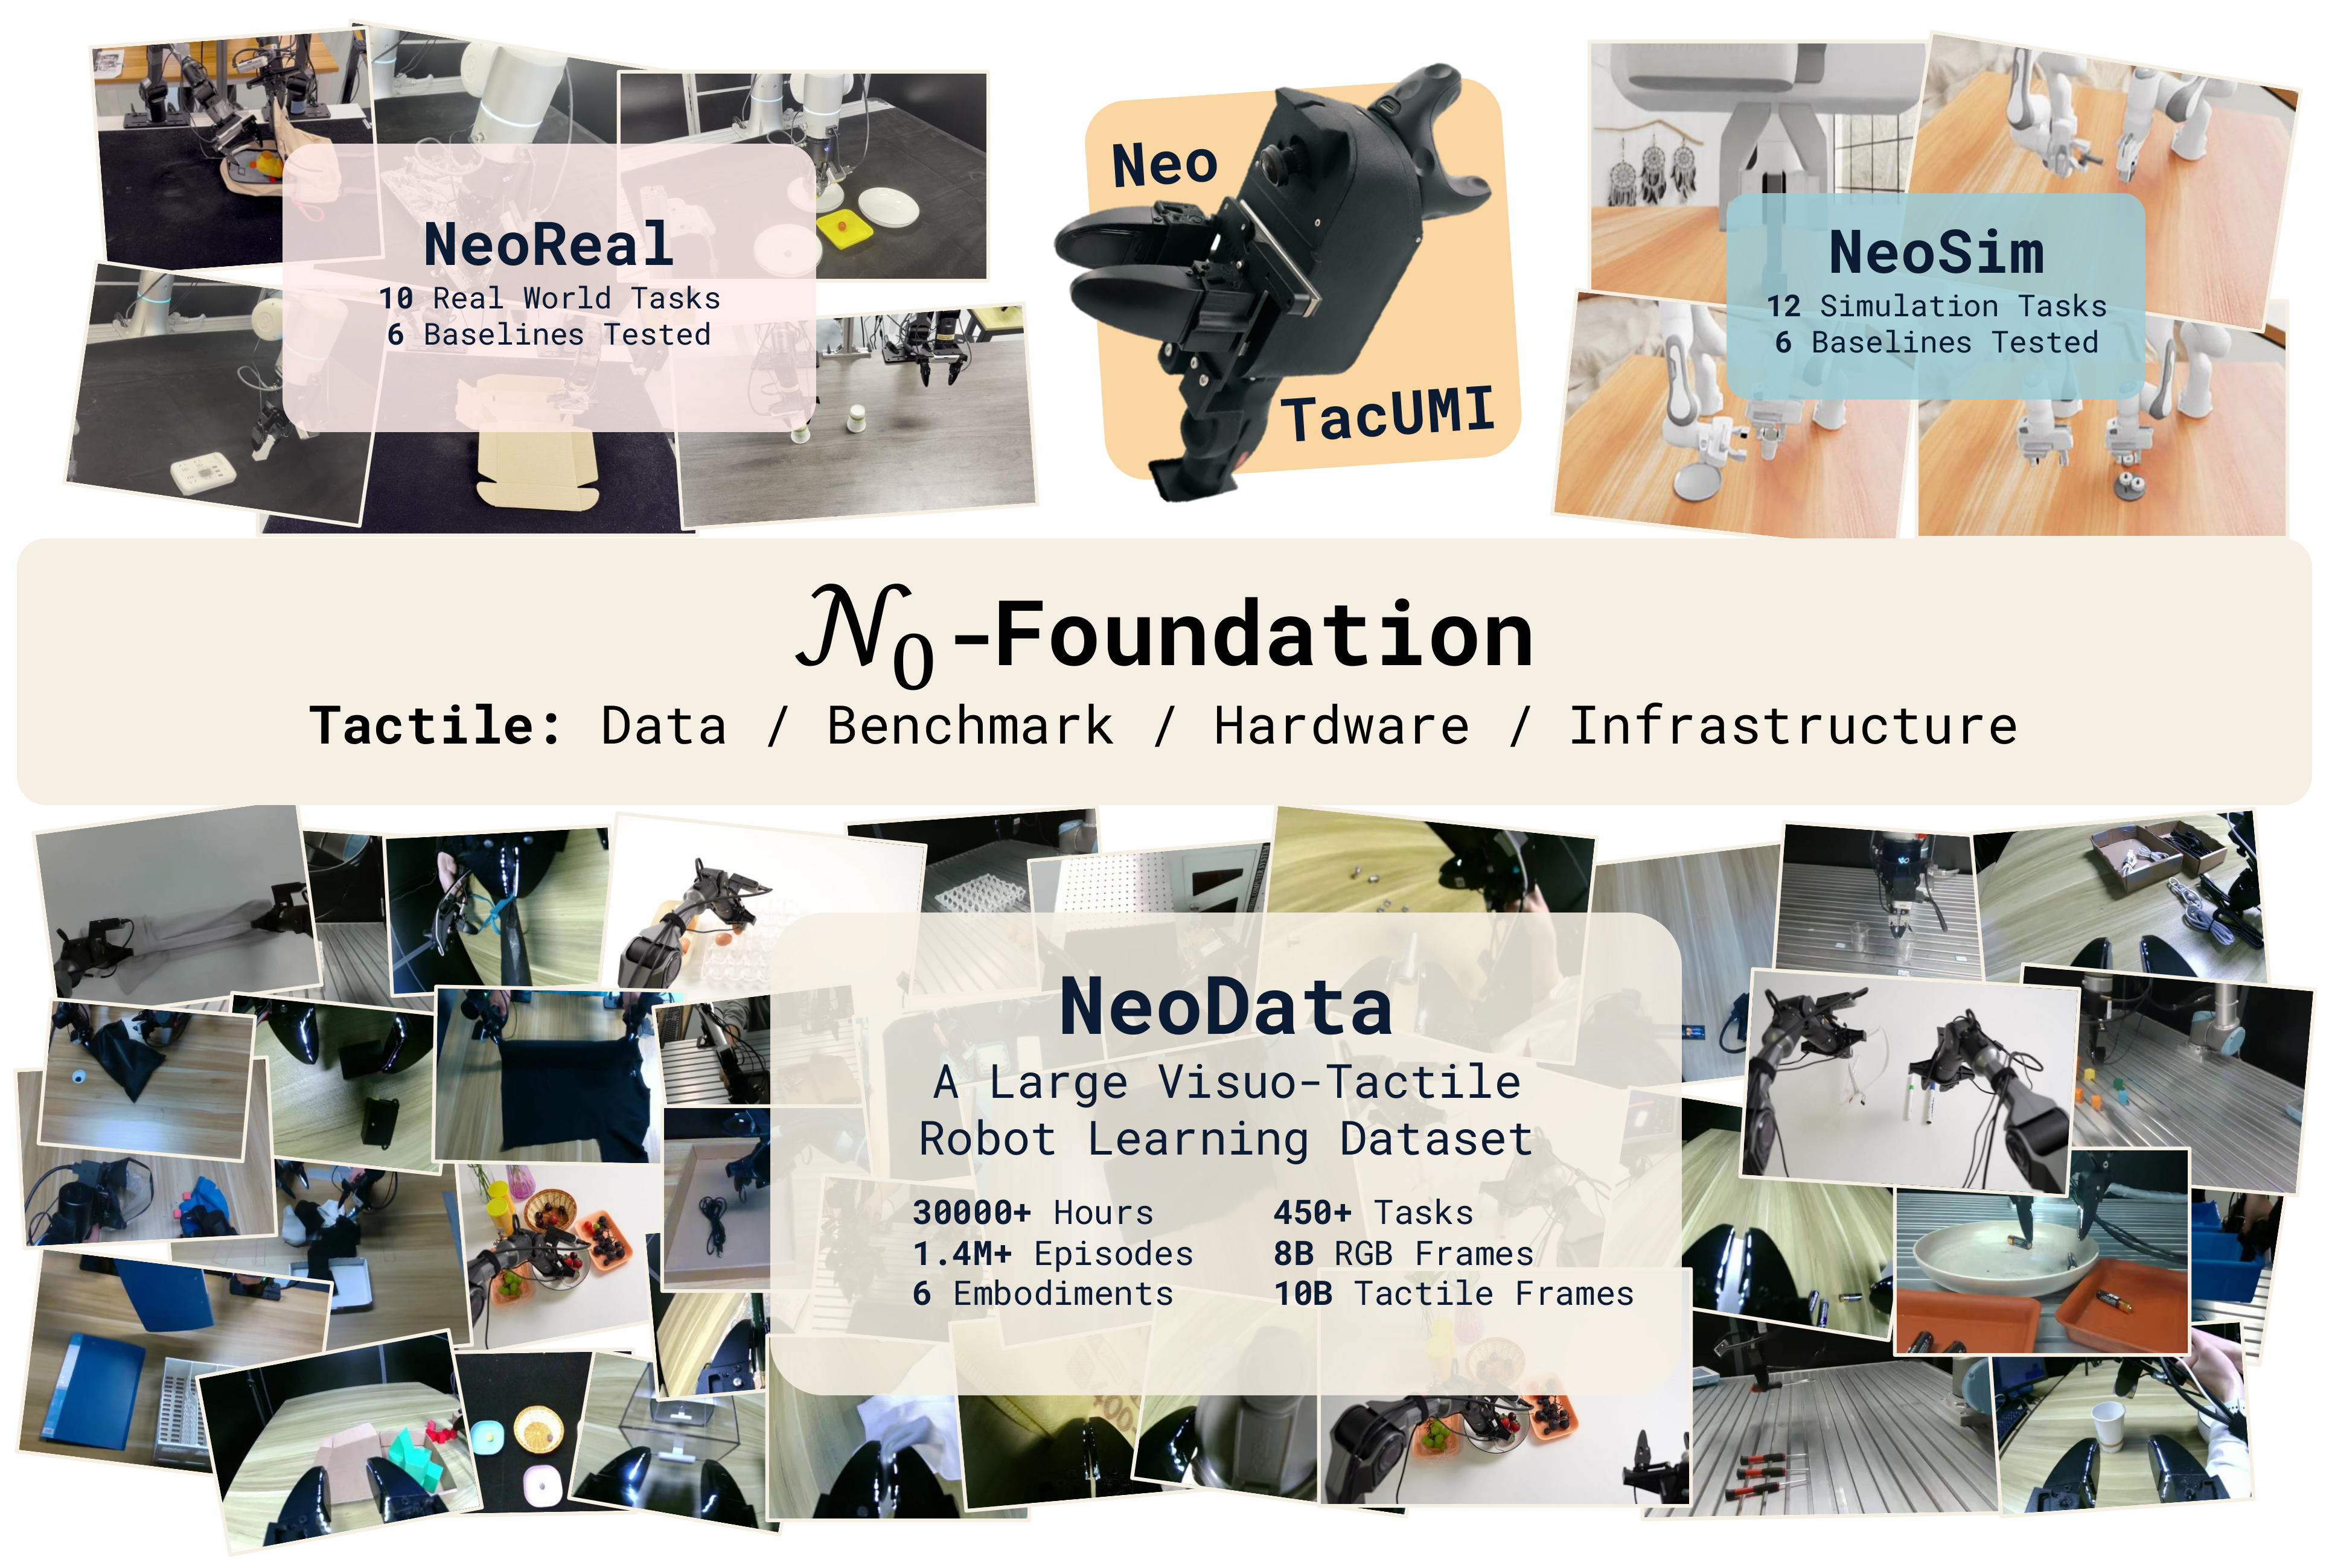
N0-Foundation: Towards the Age of Tactile Intelligence
NeoteAI Team, Fudan TEAI Team# (# corresponding author)
Technical Report 2026
N0-Foundation: Towards the Age of Tactile Intelligence
NeoteAI Team, Fudan TEAI Team# (# corresponding author)
Technical Report 2026

An Automated Pipeline for Provably Retrieval-Dependent Benchmark Construction over Dynamic Knowledge
Heng Zhou, Ao Yu, Yuchen Fan, Li Kang, Jianing Shi, Yongting Zhang, Yutao Fan, Tiancheng He, Yibing Lin, Hejia Geng, Xiufeng Song, et al.
Workshop on Failure Modes of Agentic AI at ICML 2026
An Automated Pipeline for Provably Retrieval-Dependent Benchmark Construction over Dynamic Knowledge
Heng Zhou, Ao Yu, Yuchen Fan, Li Kang, Jianing Shi, Yongting Zhang, Yutao Fan, Tiancheng He, Yibing Lin, Hejia Geng, Xiufeng Song, et al.
Workshop on Failure Modes of Agentic AI at ICML 2026
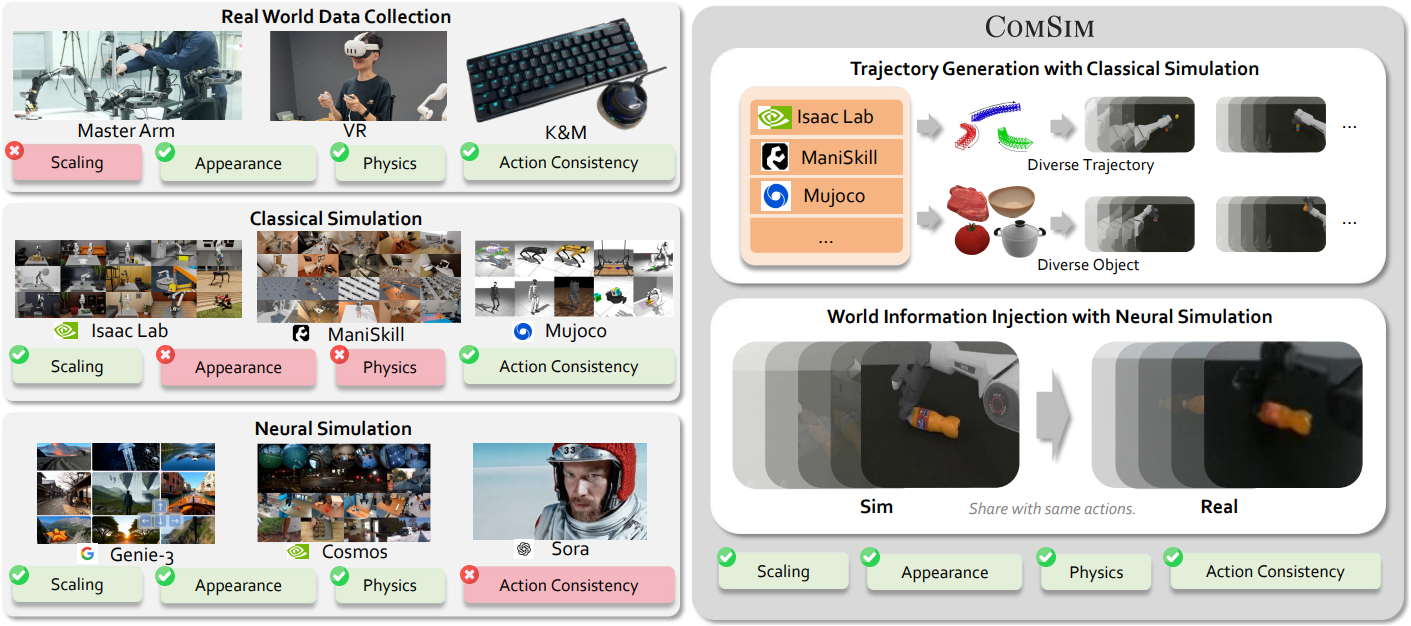
ComSim: Building Scalable Real-World Robot Data Generation via Compositional Simulation
Yiran Qin, Jiahua Ma, Li Kang, Wenzhan Li, Yihang Jiao, Xin Wen, Xiufeng Song, Heng Zhou, Jiwen Yu, Zhenfei Yin# (# corresponding author)
arXiv preprint 2026
ComSim: Building Scalable Real-World Robot Data Generation via Compositional Simulation
Yiran Qin, Jiahua Ma, Li Kang, Wenzhan Li, Yihang Jiao, Xin Wen, Xiufeng Song, Heng Zhou, Jiwen Yu, Zhenfei Yin# (# corresponding author)
arXiv preprint 2026
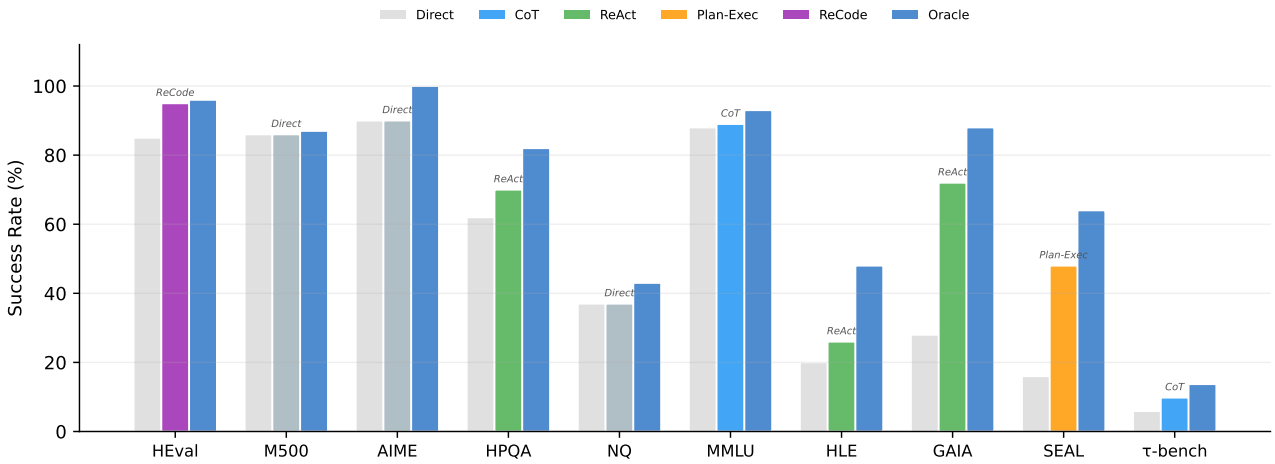
Select-then-Solve: Paradigm Routing as Inference-Time Optimization for LLM Agents
Heng Zhou, Zelin Tan, Zhemeng Zhang, Yutao Fan, Yibing Lin, Li Kang, Xiufeng Song, Rui Li, Songtao Huang, Ao Yu# (# corresponding author)
arXiv preprint 2026
Select-then-Solve: Paradigm Routing as Inference-Time Optimization for LLM Agents
Heng Zhou, Zelin Tan, Zhemeng Zhang, Yutao Fan, Yibing Lin, Li Kang, Xiufeng Song, Rui Li, Songtao Huang, Ao Yu# (# corresponding author)
arXiv preprint 2026
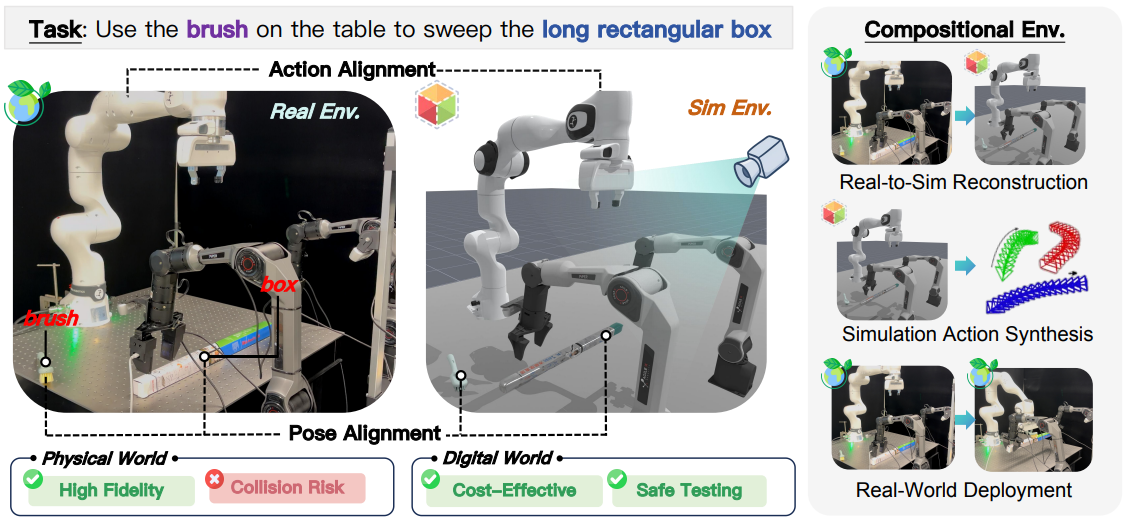
CoEnv: Driving Embodied Multi-Agent Collaboration via Compositional Environment
Li Kang, Yutao Fan, Rui Li, Heng Zhou, Yiran Qin, Zhemeng Zhang, Songtao Huang, Xiufeng Song, Zaibin Zhang, Bruno N.Y. Chen# (# corresponding author)
arXiv preprint 2026
CoEnv: Driving Embodied Multi-Agent Collaboration via Compositional Environment
Li Kang, Yutao Fan, Rui Li, Heng Zhou, Yiran Qin, Zhemeng Zhang, Songtao Huang, Xiufeng Song, Zaibin Zhang, Bruno N.Y. Chen# (# corresponding author)
arXiv preprint 2026
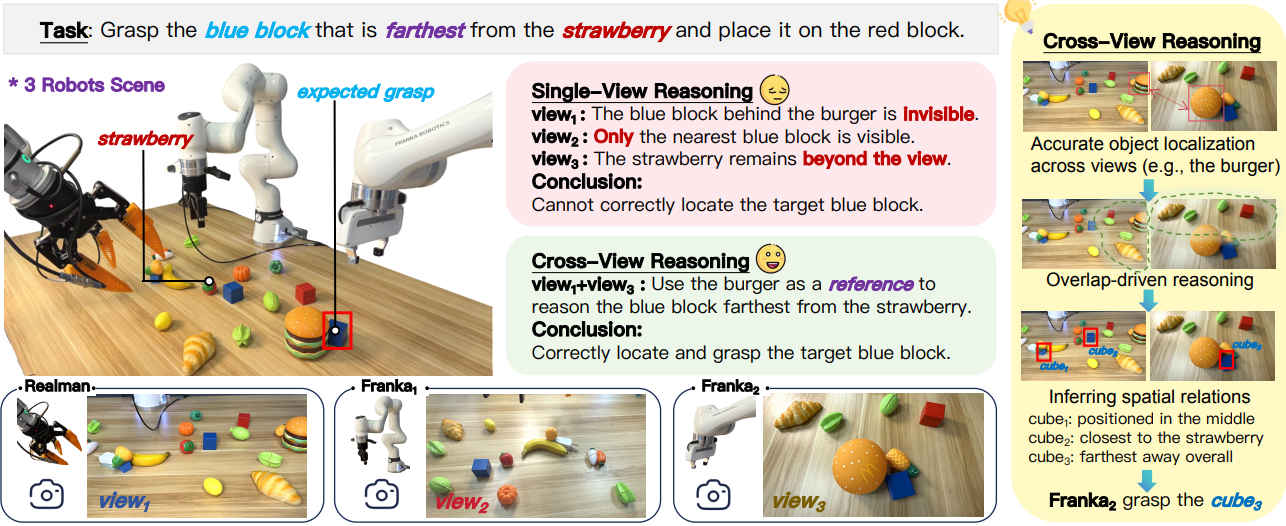
Ego to World: Collaborative Spatial Reasoning in Embodied Systems via Reinforcement Learning
Heng Zhou, Li Kang, Yiran Qin, Xiufeng Song, Ao Yu, Zilu Zhang, Haoming Song, Kaixin Xu, Yuchen Fan, Dongzhan Zhou# (# corresponding author)
arXiv preprint 2026
Ego to World: Collaborative Spatial Reasoning in Embodied Systems via Reinforcement Learning
Heng Zhou, Li Kang, Yiran Qin, Xiufeng Song, Ao Yu, Zilu Zhang, Haoming Song, Kaixin Xu, Yuchen Fan, Dongzhan Zhou# (# corresponding author)
arXiv preprint 2026
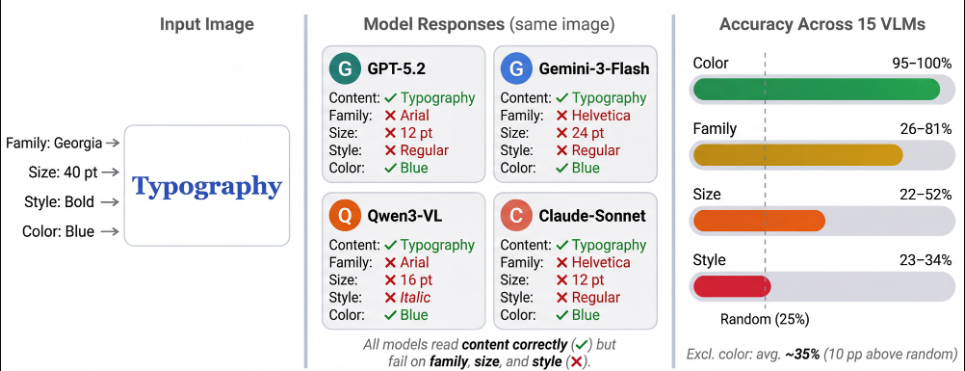
Reading ≠ Seeing: Diagnosing and Closing the Typography Gap in Vision-Language Models
Heng Zhou, Ao Yu, Li Kang, Yuchen Fan, Yutao Fan, Xiufeng Song, Hejia Geng, Yiran Qin# (# corresponding author)
arXiv preprint 2026
Reading ≠ Seeing: Diagnosing and Closing the Typography Gap in Vision-Language Models
Heng Zhou, Ao Yu, Li Kang, Yuchen Fan, Yutao Fan, Xiufeng Song, Hejia Geng, Yiran Qin# (# corresponding author)
arXiv preprint 2026
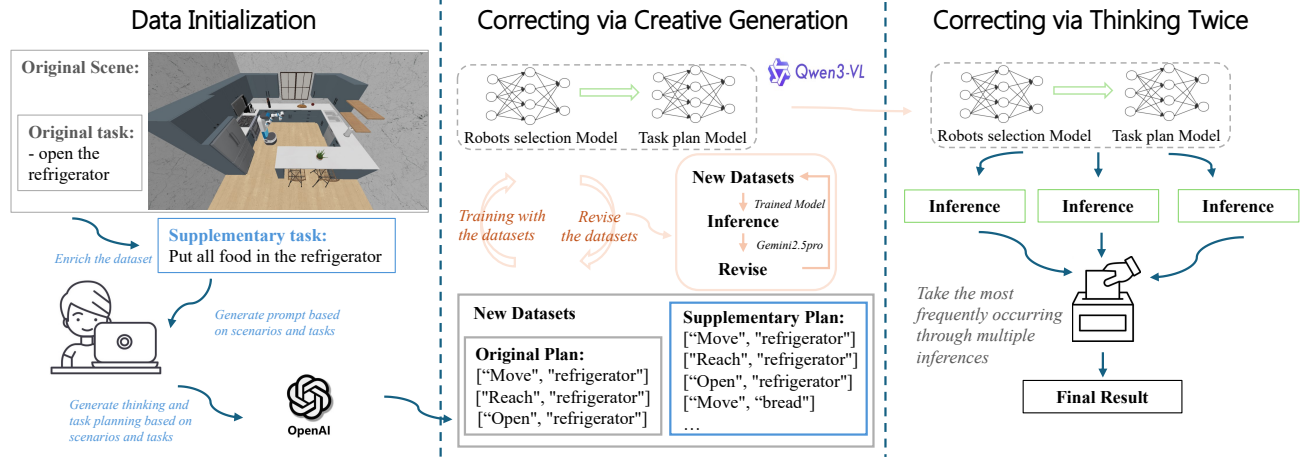
Advances and Innovations in the Multi-Agent Robotic System (MARS) Challenge
Li Kang, Heng Zhou, Xiufeng Song, Rui Li, Bruno N.Y. Chen, Ziye Wang, Ximeng Meng, Stone Tao, Yiran Qin, Xiaohong Liu# (# corresponding author)
arXiv preprint 2026
Advances and Innovations in the Multi-Agent Robotic System (MARS) Challenge
Li Kang, Heng Zhou, Xiufeng Song, Rui Li, Bruno N.Y. Chen, Ziye Wang, Ximeng Meng, Stone Tao, Yiran Qin, Xiaohong Liu# (# corresponding author)
arXiv preprint 2026
2025
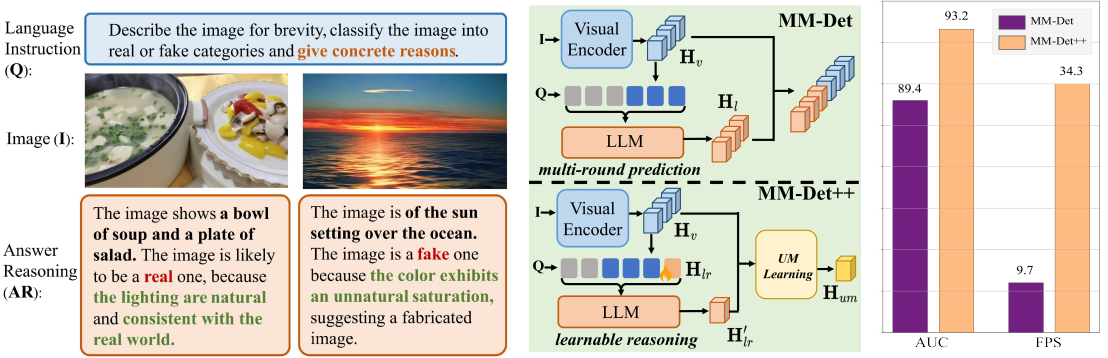
Consolidating Diffusion-Generated Video Detection with Unified Multimodal Forgery Learning
Xiaohong Liu, Xiufeng Song, Huayu Zheng, Lei Bai, Xiaoming Liu, Guangtao Zhai# (# corresponding author)
arXiv preprint 2025
Consolidating Diffusion-Generated Video Detection with Unified Multimodal Forgery Learning
Xiaohong Liu, Xiufeng Song, Huayu Zheng, Lei Bai, Xiaoming Liu, Guangtao Zhai# (# corresponding author)
arXiv preprint 2025

RoboMonster: Compositional Generalization of Heterogeneous Multi-End Effector Embodied Agents
Yiran Qin, Zhemeng Zhang, Heng Zhou, Li Kang, Bruno N.Y. Chen, Ximeng Meng, Xiufeng Song, Jiahua Ma, Zhenfei Yin, Xiaohong Liu# (# corresponding author)
arXiv preprint 2025
RoboMonster: Compositional Generalization of Heterogeneous Multi-End Effector Embodied Agents
Yiran Qin, Zhemeng Zhang, Heng Zhou, Li Kang, Bruno N.Y. Chen, Ximeng Meng, Xiufeng Song, Jiahua Ma, Zhenfei Yin, Xiaohong Liu# (# corresponding author)
arXiv preprint 2025
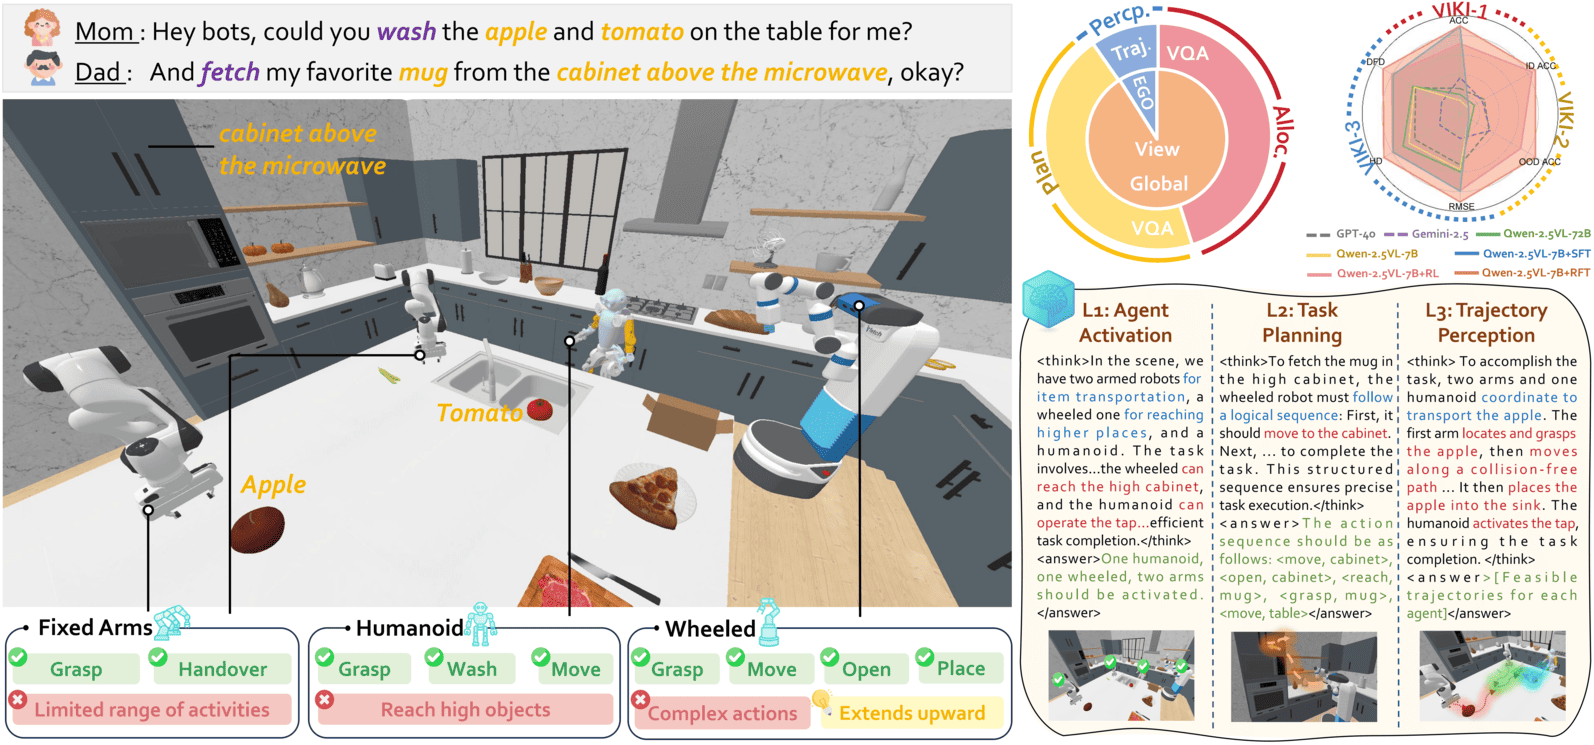
Viki-r: Coordinating embodied multi-agent cooperation via reinforcement learning
Li Kang*, Xiufeng Song*, Heng Zhou*, Yiran Qin, Jie Yang, Xiaohong Liu, Philip Torr, Lei Bai, Zhenfei Yin# (* equal contribution, # corresponding author)
Neural Information Processing Systems (NeurIPS) Benchmark 2025
Viki-r: Coordinating embodied multi-agent cooperation via reinforcement learning
Li Kang*, Xiufeng Song*, Heng Zhou*, Yiran Qin, Jie Yang, Xiaohong Liu, Philip Torr, Lei Bai, Zhenfei Yin# (* equal contribution, # corresponding author)
Neural Information Processing Systems (NeurIPS) Benchmark 2025
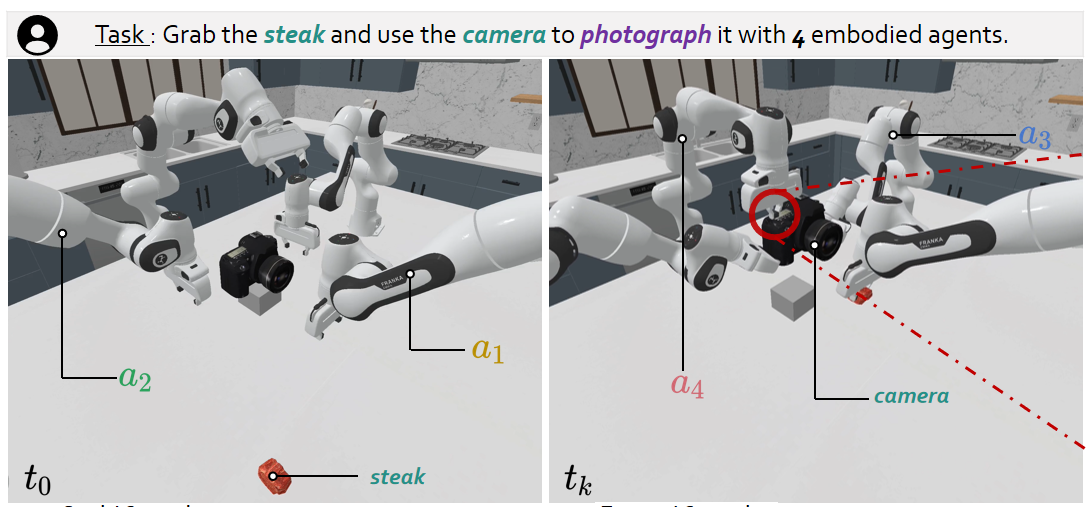
Robofactory: Exploring embodied agent collaboration with compositional constraints
Yiran Qin*, Li Kang*, Xiufeng Song*, Zhenfei Yin, Xiaohong Liu, Xihui Liu, Ruimao Zhang, Lei Bai# (* equal contribution, # corresponding author)
International Conference on Computer Vision (ICCV) 2025 Best Paper Award at CVPR 2025 MEIS Workshop
Robofactory: Exploring embodied agent collaboration with compositional constraints
Yiran Qin*, Li Kang*, Xiufeng Song*, Zhenfei Yin, Xiaohong Liu, Xihui Liu, Ruimao Zhang, Lei Bai# (* equal contribution, # corresponding author)
International Conference on Computer Vision (ICCV) 2025 Best Paper Award at CVPR 2025 MEIS Workshop